声明:以下内容转载自语言技术中心@HIT 语言技术紫丁香
论文名称:
JoPR: Joint Emotion Perception and Reasoning for Conversational Emotion Recognition
论文作者:付雨濛;黄伟韬;吴俊劼;滕浩;张梅山;刘秉权
论文链接:https://aclanthology.org/2026.acl-long.1800/
由哈工大语言技术研究中心完成,发表于ACL (CCF-A)的这篇文章《JoPR: Joint Emotion Perception and Reasoning for Conversational Emotion Recognition》,主要解决了现有大语言模型在对话情感识别中缺乏类人情感推理能力、难以准确区分相似情绪的问题。
一、动机和问题
这篇论文关注的是对话情绪识别(Emotion Recognition in Conversation, ERC)任务,也就是根据对话上下文,判断每一句话中说话者所表达的具体情绪。作者指出,随着大语言模型的发展,现有方法已经能够利用上下文、说话者信息以及外部知识来进行情绪识别,但仍然存在两个比较突出的问题。第一,很多方法更侧重于直接完成从文本到情绪标签的映射,缺乏类似人类的逐步情绪推理过程;第二,在面对语义和情感状态非常接近的情绪类别时,模型仍然容易产生混淆,比如 happy 和excited,或者angry 和frustrated。因此,作者希望模型不仅能够“感知”情绪,还能够结合上下文、说话者以及不同情绪之间的细粒度差异进行更深入的推理,从而提升对复杂和相似情绪的辨别能力。
二、研究方法
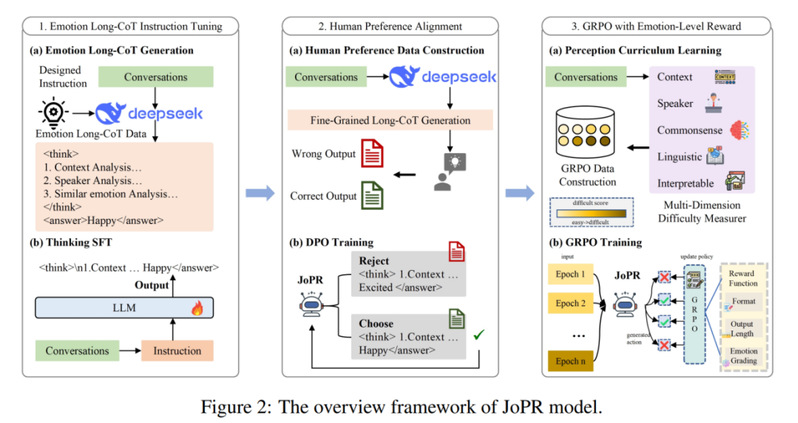
针对这些问题,作者提出了JoPR 框架,将情绪感知、课程学习和强化学习中的情绪推理结合起来。整个方法可以分成三个主要阶段。首先是长思维链监督微调,作者为模型构造结构化的情绪推理过程,让模型在预测情绪之前依次分析历史对话上下文、说话者信息,以及当前情绪与其他相似情绪之间的区别,从而让模型学习一种更加接近人类分析方式的情绪推理模式。
第二个阶段是基于DPO 的人类偏好对齐。作者从模型容易出现的错误推理中构造正负样本,例如幻觉、不准确或带有偏差的推理,并利用经过人工检查和修正的正确推理作为偏好答案。通过DPO训练,使模型不仅输出正确的情绪标签,同时尽可能生成更加合理、符合人类判断逻辑的推理过程。
最后,作者进一步引入了感知课程学习和GRPO强化学习。课程学习的核心思想是让模型按照“由易到难”的顺序学习情绪样本。作者分别从上下文、说话者、常识、语言特征和可解释性五个维度评估样本难度,并动态调整训练过程中不同难度样本的采样概率。随后,在GRPO阶段设计了专门面向情绪识别的奖励函数,其中不仅考虑输出格式和推理长度,还根据不同情绪之间的相似程度给予分级奖励,使模型在预测结果不完全正确时,也能够根据预测情绪与真实情绪的接近程度获得不同反馈,从而重点提高对相似情绪的细粒度区分能力。
三、实验结果
在实验部分,作者在IEMOCAP、MELD 和 EmoryNLP 三个常用的对话情绪识别数据集上进行了验证,并同时与传统的非大语言模型方法以及已有的大语言模型方法进行了比较。主实验结果表明,JoPR在三个数据集上都取得了最好的整体表现,说明这种将结构化情绪推理、偏好对齐、课程学习和强化学习结合起来的方式能够有效提升模型的对话情绪识别能力。
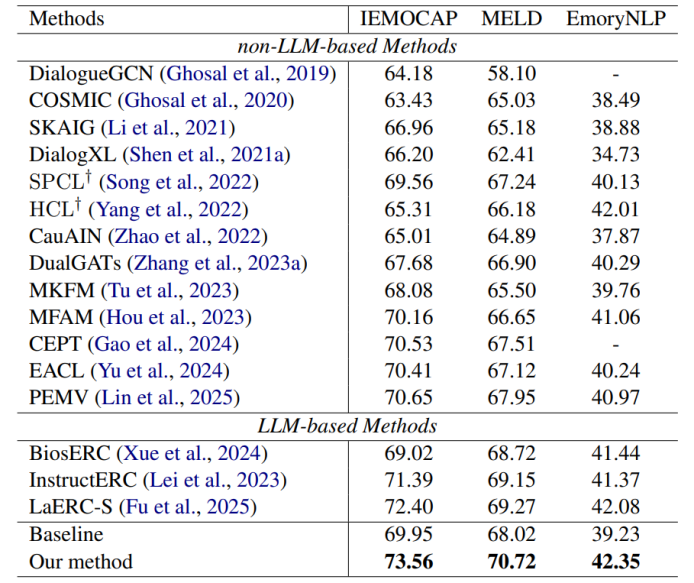
除此之外,作者还在不同基础大模型上进行了实验,结果显示该方法并不依赖于某一个特定模型,在不同模型上都能够带来稳定的性能改善,说明JoPR具有一定的模型通用性。消融实验进一步表明,长思维链训练、DPO、感知课程学习以及带有情绪级奖励的GRPO都对最终性能有贡献,其中强化学习和针对相似情绪设计的奖励机制对困难样本的识别尤为重要。整体来看,这篇论文的核心结论是:相比仅让大模型直接预测情绪标签,通过显式建模情绪推理过程,并结合由易到难的学习策略和细粒度奖励机制,可以更有效地解决相似情绪难以区分的问题。